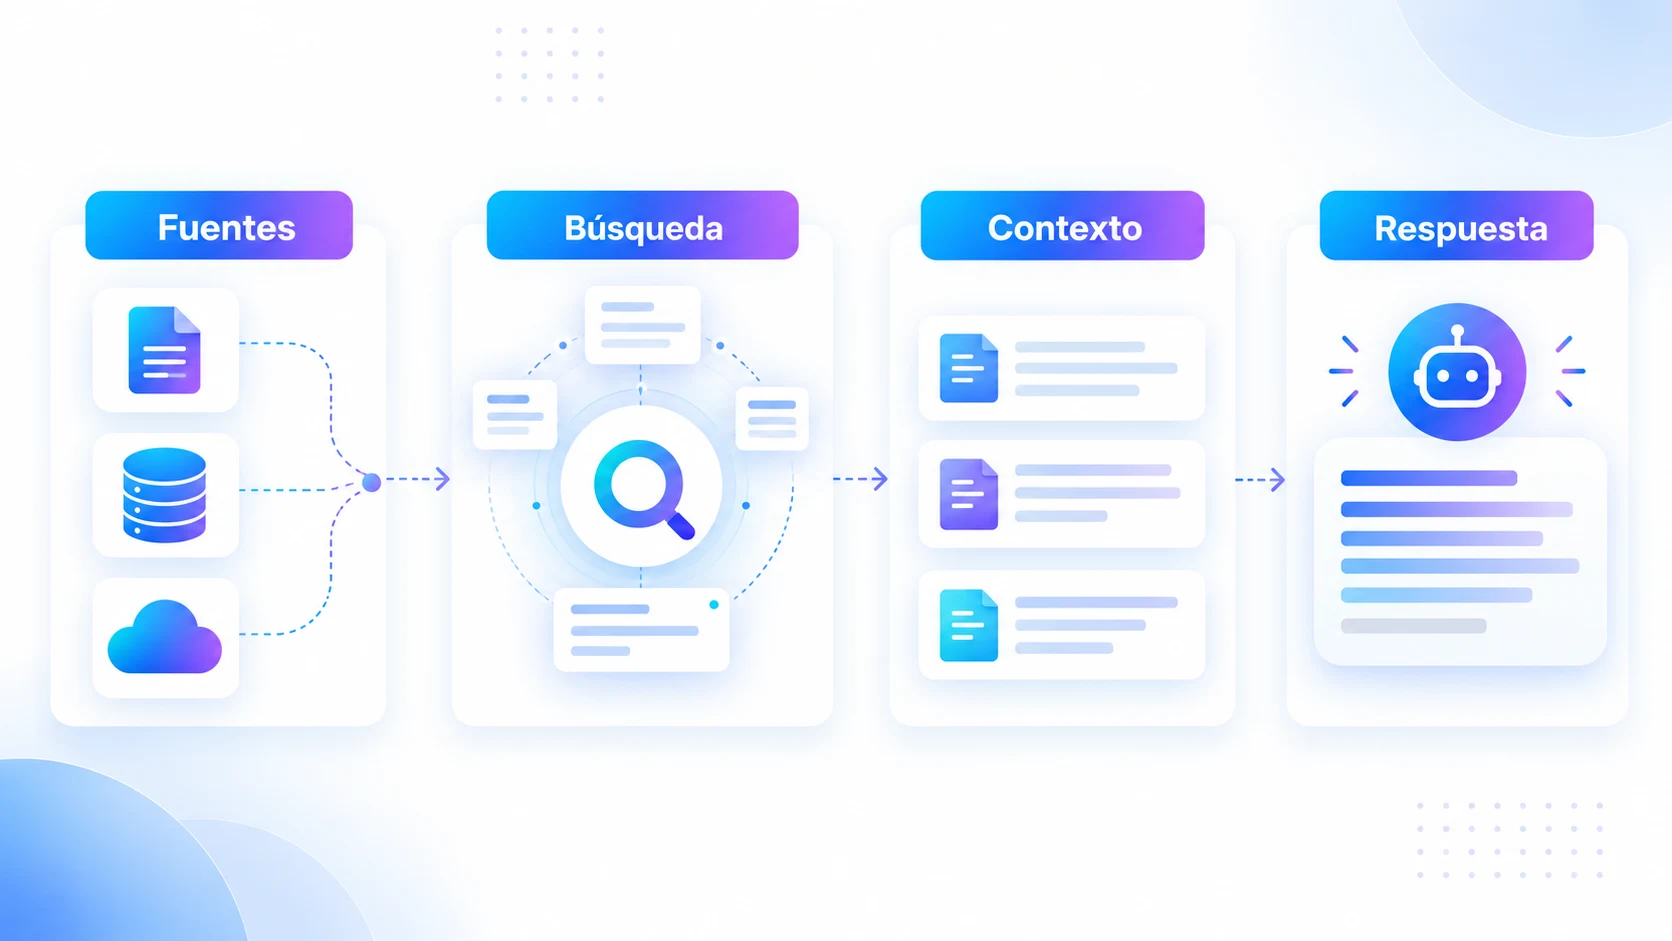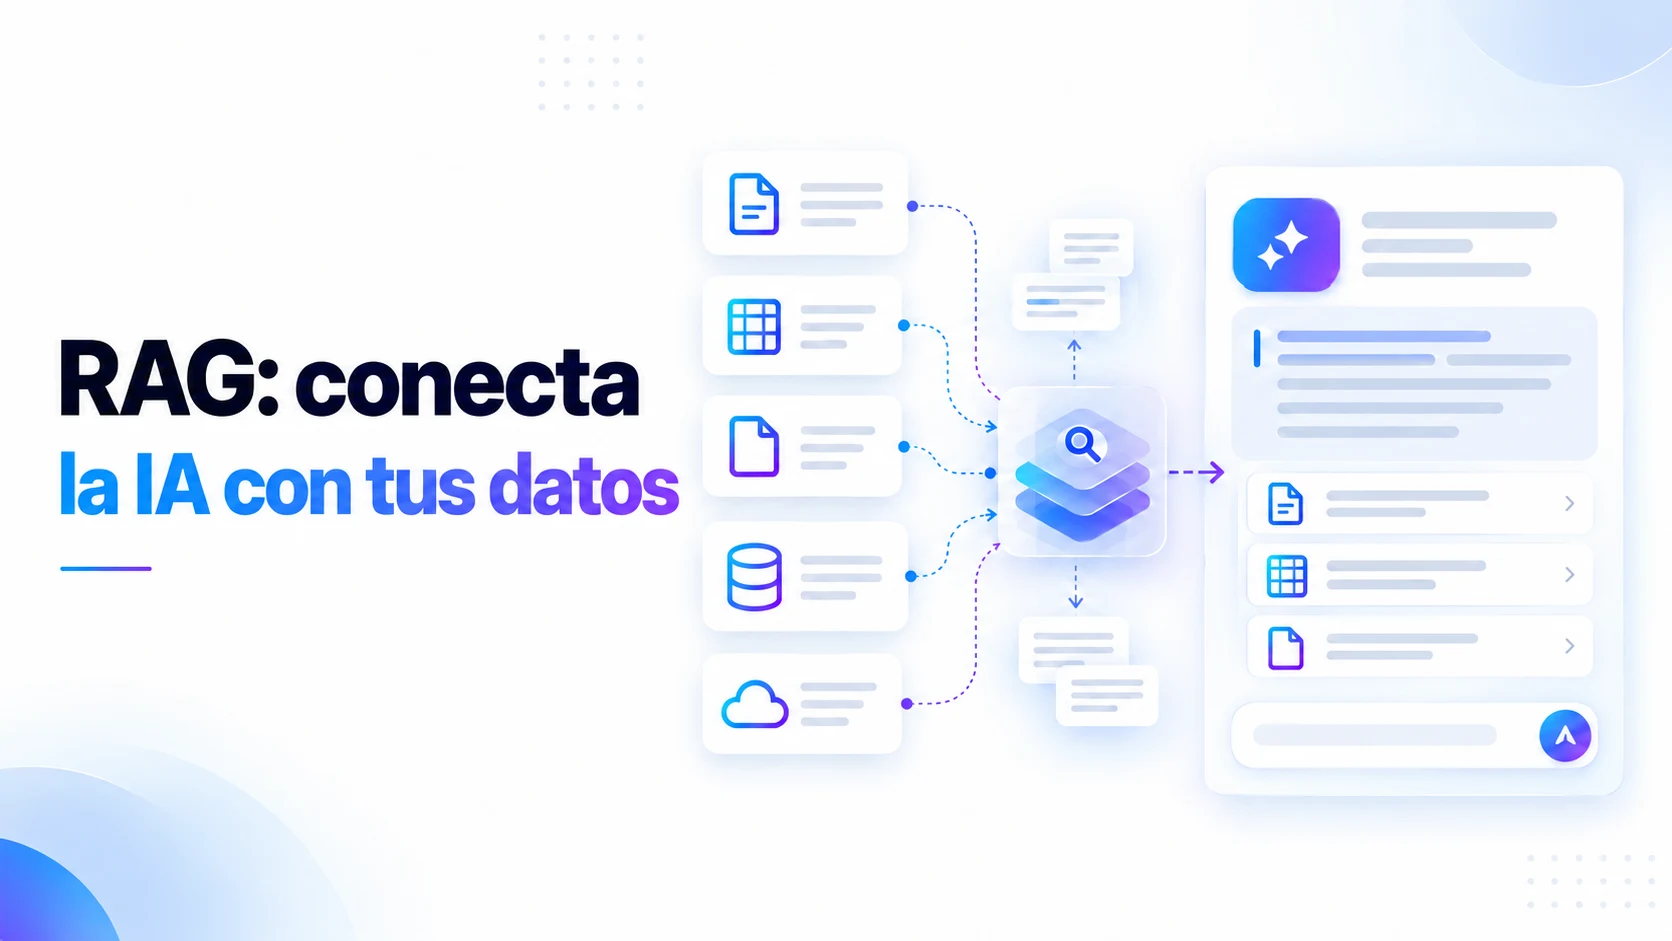
RAG permite que una aplicación de inteligencia artificial busque información relevante en fuentes autorizadas y la utilice como contexto para responder. Es una de las formas más prácticas de conectar modelos con conocimiento empresarial sin entrenarlos desde cero.
Respuesta rápida: ¿qué es RAG?
RAG significa generación aumentada por recuperación. Primero recupera fragmentos relacionados con una pregunta y después los entrega a un modelo para redactar una respuesta. Así puede trabajar con información privada, actualizada y específica.
¿Por qué un modelo no conoce tus datos?
El entrenamiento general no incluye necesariamente documentos internos ni cambios recientes. Incluso si incluye temas similares, no garantiza precisión. RAG incorpora el contexto autorizado en el momento de la consulta.
RAG vs. entrenamiento o fine-tuning
RAG aporta hechos y fuentes dinámicas; el ajuste modifica patrones de comportamiento o estilo. Para responder con conocimiento que cambia, RAG suele ser más flexible. Ambos enfoques pueden combinarse cuando la evaluación lo justifica.
RAG vs. búsqueda tradicional
La búsqueda entrega documentos o enlaces. RAG recupera fragmentos y genera una respuesta contextual. La interfaz debe conservar citas para que el usuario pueda comprobar la información original.
1. Preparación de fuentes
Selecciona documentos útiles, elimina duplicados, corrige versiones y asigna propietarios. Añade metadatos como fecha, área, producto, idioma y nivel de acceso.
2. Extracción y división
El contenido se extrae y divide en fragmentos. El tamaño debe conservar suficiente contexto sin mezclar temas. Títulos, tablas y relaciones requieren tratamiento especial.
3. Representación e índice
Los fragmentos se transforman en representaciones que permiten comparar significado y se almacenan en un índice. También pueden combinarse coincidencias semánticas con palabras clave y filtros.
4. Recuperación
La pregunta se interpreta y el sistema busca fragmentos relevantes. Puede reescribir consultas, aplicar permisos, filtrar por metadatos y reordenar resultados antes de formar el contexto.
5. Generación de la respuesta
El modelo recibe pregunta, instrucciones y contexto recuperado. Debe responder usando las fuentes, citar evidencia y reconocer cuando la información es insuficiente o contradictoria.
6. Evaluación y retroalimentación
Se mide si recuperó la evidencia correcta y si la respuesta fue fiel, completa y útil. Los errores sirven para mejorar fuentes, fragmentación, búsqueda, instrucciones o interfaz.
Casos de uso empresariales
RAG se utiliza en asistentes internos, soporte, ventas, cumplimiento, manuales técnicos, contratos y onboarding. Funciona mejor cuando existe una colección definida y preguntas con respuestas sustentables.
Diseño de permisos
Los resultados deben respetar el acceso del usuario antes de llegar al modelo. Filtra por identidad, rol y documento, y evita mezclar fragmentos de niveles diferentes.
Calidad y vigencia de datos
Una respuesta no puede superar la calidad de sus fuentes. Define publicación, aprobación, caducidad y eliminación. Muestra fecha y origen cuando influyan en la decisión.
Metadatos útiles
Producto, región, versión, audiencia, confidencialidad, autor y fecha ayudan a reducir ruido. Los metadatos deben mantenerse junto con el documento, no añadirse una sola vez y olvidarse.
Búsqueda híbrida y reordenamiento
Combinar búsqueda semántica con palabras clave mejora nombres, códigos y términos exactos. Un reordenador puede revisar candidatos y elegir los más útiles antes de generar.
Citas y trazabilidad
Vincula cada afirmación importante con su fragmento original. Las citas ayudan a verificar, corregir fuentes y generar confianza; no compensan una fuente incorrecta.
Cómo manejar falta de información
El sistema debe decir que no encontró evidencia, pedir precisión o escalar. Es preferible una abstención útil a una respuesta fluida inventada.
Seguridad frente a instrucciones maliciosas
Los documentos pueden contener texto que intente cambiar reglas o solicitar secretos. Trata las fuentes como datos no confiables, separa instrucciones y limita herramientas y permisos.
Cómo evaluar la recuperación
Mide si los fragmentos relevantes aparecen entre los primeros resultados, cuánto ruido se recupera y si los filtros respetan permisos. Crea preguntas con evidencia esperada.
Cómo evaluar la respuesta
Evalúa fidelidad a la fuente, cobertura, claridad, citas, utilidad y abstención. Incluye preguntas ambiguas, conflictivas, fuera de alcance y con fuentes desactualizadas.
Rendimiento y costo
Controla tamaño del contexto, número de fragmentos, modelos, caché y latencia de búsqueda. Optimiza después de medir calidad para no ahorrar a costa de respuestas incompletas.
Ruta de implementación
Empieza con una colección y audiencia limitadas. Define preguntas, prepara fuentes, crea evaluación, implementa búsqueda, agrega generación y prueba permisos antes de ampliar.
Errores frecuentes
Evita indexar todo sin selección, ignorar permisos, dividir documentos sin estructura, no mostrar fuentes, evaluar solo respuestas fáciles y confundir RAG con garantía de verdad.
Preguntas frecuentes
¿RAG elimina las alucinaciones?
No. Reduce parte del riesgo al aportar evidencia, pero el modelo todavía puede interpretar mal, mezclar fuentes o generar afirmaciones no sustentadas.
¿Necesito una base vectorial?
No siempre. Depende del volumen y la búsqueda. Puede combinarse un índice semántico con texto completo, bases existentes y filtros.
¿Qué documentos debo incluir primero?
Los más consultados, vigentes y bien gobernados, con preguntas reales y una persona responsable de validar respuestas.
Conecta conocimiento con respuestas confiables
RAG convierte fuentes empresariales en contexto verificable cuando se diseña con calidad, permisos y evaluación. En Anubbe construimos soluciones que conectan la IA con información útil sin perder trazabilidad ni control.